多组学数据如何提升基因组预测?
本文保留2019年研究结果及作者讨论,参考文献采用核验后的正式题名、卷期和页码。
上期学术文章速览,我们带大家读了几篇有关全基因组关联分析(GWAS)的文献。而如何用基因型(genotype)来有效预测表型(phenotype)仍是本世纪一大难题。所以本期学术文章速览,我们将介绍用多组学数据来进行基因组预测的相关文章。
第一部分:多组学数据(基因组、转录组、代谢组)用于基因组预测
杂交水稻的多组学预测
Wang et al. 2019. Identification of optimal prediction models using multi-omicdata for selecting hybrid rice. Heredity. 395–406.
https://www.nature.com/articles/s41437-019-0210-6
基因组预测(genomic prediction)有助于增加选择强度,加速育种周期,对杂交水稻育种有很大意义。随着科学技术的飞速发展,其他“组学”(例如代谢组学、转录组学等)的数据也更多了起来,这些数据可以被用于进一步对农艺相关重要性状育种值的预测。
在此项研究中,研究者用不同的预测模型对多组学数据(基因组、转录组、代谢组)所有可能的组合做出综合评估,从而确定杂交稻的产量、千粒重、穗粒数、分蘖数(表型数据来自源于汕优63的重组自交系,及其随机杂交而成的F2)的最佳预测策略。研究表明,在水稻中,由基因组和代谢组数据相结合而进行的预测相比于单一组学数据、或其他的组合得到更好的结果。
研究者试验了不同的预测方法,包括最小绝对收缩和选择算法(least absolute shrinkage and selection operator,LASSO)、随机变数选取法(stochastic search variable selection,SSVS)、不同核函数(高斯径向基核函数、多项式核函数)和参数(epsilon回归、nu回归)的支持向量机回归(support vector machines with radial basis function/polynomial kernel and epsilon/nu regression,SVM-R(EPS),SVM-R(NU),SVM-P(EPS),SVM-P(NU))、偏最小二乘回归(partial least squares regression,PLS)等。与众多常用方法相比,最佳线性无偏预测(best linear unbiased prediction, BLUP)看起来是最稳定的预测方法。
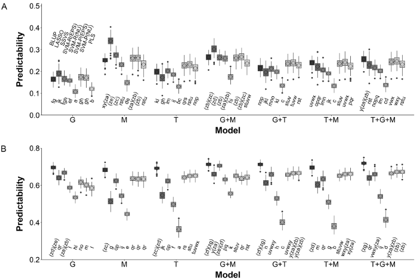
图:七种不同组学数据和八种预测方法的组合展现不同性状的可预测性:产量(YIELD,图A),千粒重(KGW,图B)。
杂交水稻的育种该使用何种组学数据,运用哪些方法能提升性状的可预测性?此项研究为这些问题提供了指导意义,本研究的结果既有益于学术研究,又有利于降低业界育种和选育工作的成本。
——魏巨龙供稿
延伸阅读:
Xu et al. 2016. Metabolomic prediction of yield in hybrid rice. Plant J. 88:219–227.
https://onlinelibrary.wiley.com/doi/full/10.1111/tpj.13242
水稻为全球逾百分之五十的人口提供了稳定的粮食来源。增加水稻的产量可为全球人口提供有效的粮食保障。杂交育种可以为实现这个目标助力,因为杂交水稻的产量通常比纯合种的产量高很多。
我们最近开发了一种基于遗传标记的预测方法来预测哪些基因组杂交育种可以显著提高产量。目前我们有转录组和代谢组的数据来作为预测的原材料。运用六种预测方法,包括LASSO、BLUP、SSVS、PLS、SVM-R、SVM-P,我们发现将转录组和代谢组数据加入预测模型,可以提高对杂合产量的预测能力。LASSO和BLUP是预测产量的最有效方法。对于高遗传力的性状而言,基因组数据仍是最有效的预测变量。当加入代谢组数据后,对杂合产量的预测能力几乎比只用基因组预测增加了一倍。
从210个重组自交系推断出来的21,945个可能的杂交种中,我们通过代谢产物预测出其中的前十名,它们的预测产量有可能提高30%左右。我们假设每一种代谢产物代表了遗传网络中对于产量的生物学预设,因此,运用代谢产物进行产量的预测就相当于是利用了那些在遗传网络中的隐藏信息。
将基因表达数据纳入预测
Li et al. 2019. Integrating gene expression data intogenomic prediction. Front. Genet. 10:1–11.
https://www.frontiersin.org/articles/10.3389/fgene.2019.00126/full
基因表达谱可以为育种值和表型的预测提供很有价值的信息。本项研究中,我们运用转录组数据测试了在185个雌雄果蝇自交系中的九个性状的表型预测。
我们采用了两种方法将转录组数据加入到基因组预测中:基因组和转录组最佳线性无偏预测(GBLUP + TBLUP => GTBLUP),以及基因组最佳线性无偏预测加上再生核希尔伯特空间回归(GBLUP + RKHS => GRBLUP)。这两种方法都将单核苷酸多态性数据(SNPs)与转录组相结合。我们用基因型数据来构建加性(additive)基因组关系,再将其用于基因组最佳线性无偏预测(GBLUP)中,再加上一个基于转录组的混合线性模型,其核函数可以是线性(linear kernel,GTBLUP)或高斯(Gaussian kernel, GRBLUP)。
我们研究了不同模型的预测能力,并讨论了多组学时代“组学加持的广义遗传性力”这一概念。对于大多数性状,GRBLUP和GBLUP的预测能力大致相当,但是GRBLUP可以解释更多的表型方差。对于其中一个性状(雌性果蝇对丁酸乙酯的嗅觉)的预测能力,GRBLUP(0.23)显著高于GBLUP(0.21)。
我们的结果表明,在更大范围内加入对转录组数据的考虑,或许可以改进基因组预测。
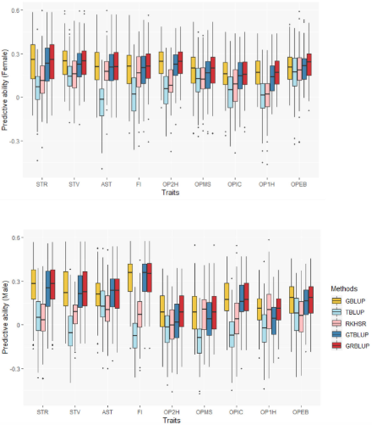
图:五种不同模型对雌雄果蝇中九个性状的预测能力。
玉米复杂性状的转录组预测
Azodi et al. 2019. Transcriptome-based prediction of complex traits in maize. Plant Cell. 2020;32(1):139–151.
http://www.plantcell.org/content/early/2019/10/22/tpc.19.00332
通过全基因组测序信息来预测性状的能力(基因组预测)加深了我们对复杂性状遗传基础的理解,也不断改变着我们育种实践的方式。而转录组数据也对基因组预测有所帮助。然而,目前用转录的量来进行性状预测的准确程度尚不明确,尤其对那些不同发育阶段数据不同的性状而言。
利用玉米遗传标记和种子转录程度来预测成熟玉米的性状,我们发现转录产物和遗传标记模型的预测表现比较相似。当转录组和最重要的遗传标记被用于同一个联合模型当中时,预测能力有所提升。此外,在预测模型中重要性高的那些遗传标记与重要的转录产物并不接近,也不同于转录产物的调控变异。这些结果表明,转录产物的量对于性状预测有一定帮助,而转录数据的预测能力并不是简单地归功于被转录基因组区间的遗传变异。
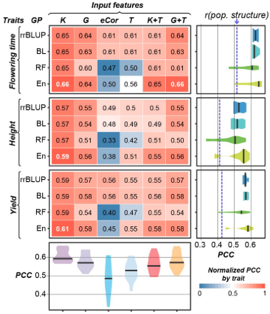
图:四种算法对于三个性状的预测数值与真实数值之间的皮尔逊相关系数
最后,遗传标记模型只确定了14个被用作基准的开花时间基因当中的1个,而转录组模型确定了其中的5个基因。因此,转录组数据不仅是对基因组预测有帮助,它更是连接某些性状和变异的重要线索,这是在测序层面难以捕捉的。
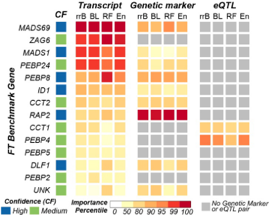
图:转录产物和遗传标记对基准开花基因预测,预测能力高的转录产物与遗传标记不重合。
延伸阅读:
Riedelsheimer et al. 2012. Genomic and metabolic prediction ofcomplex heterotic traits in hybrid maize. Nat. Genet. 44:217–220.
https://www.nature.com/articles/ng.1033
玉米既是植物遗传学研究中非常好的模式生物,更是世界范围内重要的作物,它可用于粮食、动物饲料、生物能源等。最近的全基因组关联分析研究和代谢分析(metabolic profiling)致力于解析数量性状的主效遗传位点和关键的代谢调节因子。
这里我们介绍另一种方法,通过大规模的基因组和代谢信息来预测在测交杂种(hybrid testcrosses)中复杂的、多基因遗传的性状。我们采集了全球范围内285个马齿型(Dent)自交系玉米并将其与两个测试种进行杂交,用56,110个SNPs和130个代谢产物预测了杂交玉米中七种与生物质和生物能源相关的性状。我们通过拟合所有SNPs和代谢产物的统计效应,构建了全基因组和代谢预测模型。由SNPs得到的预测准确率范围为0.72至0.81,而代谢产物的预测准确率范围为0.6至0.8。由此我们可以可靠地从大量不同的自交系中筛选有潜力产出优良杂种后代的品种。
第二部分:环境影响、深度学习等应用于基因组预测
不同环境下的玉米产量预测
Millet et al. 2019. Genomic prediction of maize yield across European environmental conditions. Nat. Genet. 51:952–956.
https://www.nature.com/articles/s41588-019-0414-y
研究种质发育对气候变化的适应性对粮食保障有重要意义。基因组预测是评估基因型的有力工具,但当环境情形不同时(由于基因-环境互作),除了开花时间的相关预测结果较好外,对其他性状的预测仍表现欠佳。
随着传感器技术的发展,传感器网络可以覆盖上千块田地的环境表征监测,这为研究基因-环境互作开启了新的可能。由此我们提出一种在基因型-环境相互作用下进行种质鉴定的新策略。我们用籽粒的重量和数量来代表产量,与这些性状相关的基因型-环境互作则由不同基因型对环境驱动因素的敏感性(genotypic sensitivity)来体现。
环境表征的确定则使用从每块试验田的传感器数据计算得出的特定基因型指标,以及在表型平台上针对每种基因型校准后的玉米物候(phenology)变化。通过对基因型敏感性(genotypic sensitivity)的全基因组回归分析方法,我们可以在多变的环境情景中,准确预测在基因型-环境互作影响下的玉米产量,而且预测能力优于基准方法。
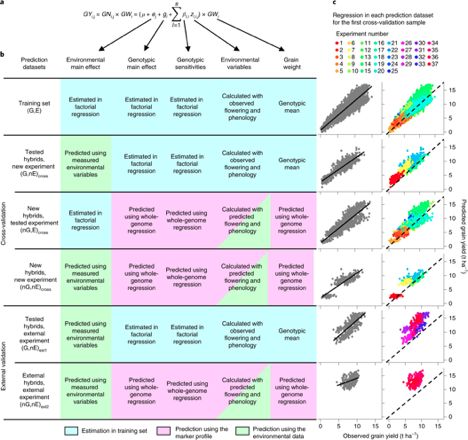
图:不同数据集和不同方法的产量预测结果。
深度学习与复杂性状预测
Pérez-Enciso and Zingaretti. 2019. A guide for using deep learning for complex trait genomic prediction. Genes. 10(7):553.
https://www.mdpi.com/2073-4425/10/7/553/htm
深度学习越来越成为通过复杂数据(如图像、文字、视频等)来进行准确预测的有力工具。然而,深度学习从分子数据来预测表型值的能力仍待研究。这里我们介绍了深度学习的理论基础,并提供了一段具有普适性的代码,代码可以被简单修改以作更特定的用途。
深度学习包含很多的算法,这些算法依赖于不同的超参数设定。对这些超参数值进行谨慎的优化是避免过拟合(overfitting)的关键。在目前已试用于基因组预测的深度学习结构中,卷积神经网络(convolutional neural networks,CNNs)似乎比多层感知器(multilayer perceptrons,MLPs)更有前景。
深度学习的局限性在于它得到的结果比较难以理解。这可能对动植物育种的基因组预测影响较小,但当用于决定疾病的遗传风险时,就会比较困难。虽然深度学习技术并不是“即插即用”,但可以利用如Keras或TensorFlow等公共软件来实现。我们提供了基于Keras的代码,来更好地说明以上深度学习的相关内容。GitHub链接:https://github.com/miguelperezenciso/DLpipeline
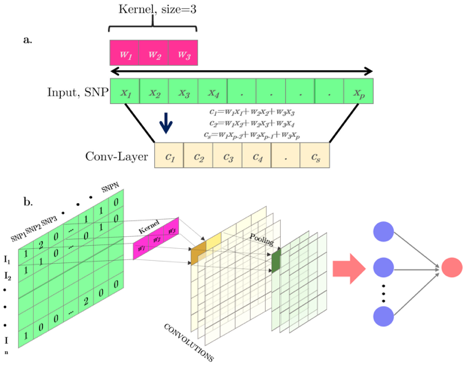
图:CNN用作基因组预测示意图
讨论时间
编者按:多组学时代,我们可以采集和分析的数据越来越多了,将基因组、转录组、代谢组、蛋白组等等不同的数据应用于基因组预测,是否可以帮助我们更好地认识复杂性状,准确地预测重要性状,帮助制定育种或杂交计划,促进农业、林业、畜牧业等的发展呢?
小编在整理本期的论文时,想到了以下几个问题,希望大家可以在评论区共同讨论一下:
转录组和代谢组数据会受到环境的影响,在预测模型中如何体现?不同于基因组,转录组和代谢组数据采集时必须需要把植物种出来才可以,比如要等到种子发芽、叶片生长、开花结果、植物成熟以采集不同组织等。这就使实验的周期加长,那会不会增加育种工作的成本?多组学数据共同用于一个模型中,如何归一化、标准化这些数据,使它们有可比性?多加一层数据后预测能力的增加,是否多于这些数据所带来的噪声?前景展望:作物生长模型分析、环境互作、机器学习以及深度学习助力于基因组预测,是否是这一领域的未来发展方向?
请大家在评论区畅所欲言,希望多组学数据助力基因组预测在未来有更好的发展。
参考文献
- Wang S, Wei J, Li R, Qu H, Chater JM, Ma R, Li Y, Xie W, Jia Z. Identification of optimal prediction models using multi-omic data for selecting hybrid rice. Heredity. 2019;123(3):395-406. DOI: 10.1038/s41437-019-0210-6
- Xu S, Xu Y, Gong L, Zhang Q. Metabolomic prediction of yield in hybrid rice. The Plant Journal. 2016;88(2):219-227. DOI: 10.1111/tpj.13242
- Li Z, Gao N, Martini JWR, Simianer H. Integrating Gene Expression Data Into Genomic Prediction. Frontiers in Genetics. 2019;10:126. DOI: 10.3389/fgene.2019.00126
- Azodi CB, Pardo J, VanBuren R, de los Campos G, Shiu SH. Transcriptome-Based Prediction of Complex Traits in Maize. The Plant Cell. 2020;32(1):139-151. DOI: 10.1105/tpc.19.00332
- Riedelsheimer C, Czedik-Eysenberg A, Grieder C, Lisec J, Technow F, Sulpice R, Altmann T, Stitt M, Willmitzer L, Melchinger AE. Genomic and metabolic prediction of complex heterotic traits in hybrid maize. Nature Genetics. 2012;44(2):217-220. DOI: 10.1038/ng.1033
- Millet EJ, Kruijer W, Coupel-Ledru A, Alvarez Prado S, Cabrera-Bosquet L, Lacube S, Charcosset A, Welcker C, van Eeuwijk F, Tardieu F. Genomic prediction of maize yield across European environmental conditions. Nature Genetics. 2019;51(6):952-956. DOI: 10.1038/s41588-019-0414-y
- Pérez-Enciso M, Zingaretti LM. A Guide on Deep Learning for Complex Trait Genomic Prediction. Genes. 2019;10(7):553. DOI: 10.3390/genes10070553
评论(0)
登录后即可发表评论。
登录暂无评论,来发表第一条评论吧!