三代测序技术问答:变异检测、数据格式与读长
本文是2019年的匿名讨论存档,原编辑已明确隐去姓名单位。有关错误率、通量和HiFi/CLR的发言是当时讨论,不能直接作为当前实验参数。
关于高通量测序与分析软件
Q:各位大神,我们用Nanopore 测序的数据,和参考基因组比较找片段差异,有什么好的软件推荐 A:片段差异是指SV吗? 做这个的话Sniffles还可以,mapping用他们推荐的NGMLR或者minimap2 A:sniffles是nanopore自己的发文章用的;好像还有个nanosv A:我们用pacbio的数据做sniffles,出来的结果很难解释,各种噪声
Q:感谢各位大神,我就是想用nanopore的长reads map一下基因组,看看特定区段上的序列插入缺失,确定我们关注区段上的基因位置。覆盖度比较低,是不是不太可靠? A:插入缺失的片段有多长?如果比较长应该可以看到。只要看到一条 read 里包含了断点,就可以断定了。但是得看运气。
Q:几个基因的区段,20k大小的长度
Q:pacbio与nanopore测试数据,哪个错误率低啊。最近实验室准备用长前段测序,call snp,但是错误率是个麻烦问题,对于low depth数据 A:错误率类似,但是 pacbio 错误随机,可以随着覆盖度提高完全消除。Nanopore 则有偏向性, homopolymer 会偏向较短。不要用低覆盖度的 long read call snps。 A:感觉long reads 做SV 还好,做SNP可能错误率很高,或许还不如用NGS。话说long reads call SV的软件, 关于pbsv, sniffles, nanosv大家有没有比较过?哪个比较推荐?貌似这几个的结果会不一致,不知道有没有分析比较三者的差异? A:其实我们用sniffles也是很多噪音, 大概是我们测的基因组太复杂了。
Q: 你们怎么过滤sniffles结果的?
Q:有特定的参数设置么?我们恐怕就不过滤了,层数太低
A:min_support、min_length,然后还是要有a priori information去专注于一个区域(de novo我们还是不敢做) A:如果你的reference genome不大,比较划算的做法应该是NGS,当然,不差钱的话,用新技术也是好的,文章在技术层面有亮点 。 A:Pacbio在读取homopolymer 也会出错(酶的读取速度太快了,就一个单分子模板,难免出错),同样的道理,可以通过CCS去除这种短的插入或缺失。另外,大家可能需要更正下观念,pacbio用于calling snps其实the upper bound of error rate 也就1%,其余的error是Indel。所以,对于snp反而不太敏感(相较于Indel)而言。当然,群里绝大部分都是做whole genome的,对于target sequencing,有一个策略可以将error rate降到0.1%以下,就是通过第一轮PCR扩增的时候加入UMIs,实操表明,一个UMI只要被测到3次以上,基本上多有的error都可以去除。对于一个分子本身,ccs passes >=10的话,基本上没有Indel的error.
Q:请问 “一个UMI只要被测到3次以上,基本上多有的error都可以去除” 怎么识别正确的umi;对应的无error 的reads A:好问题,没有很好的办法识别什么叫正确。可以通过人为加入特定的序列,然后评估。实际操作只能通过mean quality 以及low quality还有特殊的设计的UMI sequence structure. UMI如果有一些结构特征,识别起来要容易些。然后mean quality可以去除很多的error,这一点你可以把同样长度的UMI跟UMI附近的target sequences比较,进而评估cutoff。low quality for bases是很严的cutoff,“宁缺毋滥”的意思。
Q:你指的是pcr和sequencing error吗?有个package叫fgbio,就干这个的,根据umi来correct error。 A:fgbio不识别pacbio的long reads? pacbio的long reads出来的UMIs长度不等。
Q:那个package根据umi family找consensus call。 A:都会有可能,错误可能在 pcr 之前就是错的,也有可能pcr多次后才开始。 A:你可能没明白UMIs的作用,pcr之前的属于引物合成错误,只能靠谱的公司以及贵的纯化方式,反正也就一条。again,一些结构设计可以避免完全NNNNNNN(n)的这种高错误模式。另外,pcr之后引入的error,UMI轻松可以破解,UMIs就是干这个的。 A:如图:
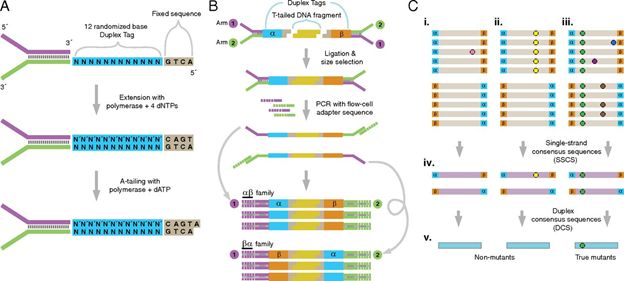
编者注:Schmitt MW et al. 2012. Detection of ultra-rare mutations by next-generation sequencing. Proc. Natl. Acad. Sci.109:14508 – 14513. A:pacbio 虽然有 homopolymer error,但错误是随机分布的,只要测序深度够深,理论上可以知道正确的长度。但 Nanopore 据说是先天有 bias, 错误不随机。这就是为什么大家做 De novo 还是喜欢 pacbio. 不过 Nanopore 也是在进步,最新的算法可能会比较准确些,最近没有关心了,不知道准确些了没有。如果是做 De Novo 目前还得需要二代测序来纠正小错误
Q:哈哈,我不做基因组组装。目前只做过target sequencing。如果我想通过RNA-seq来看一个转基因的表达转录本情况,我是直接将插入的片段或质粒作为ref.fa还是在genome.fa的后面加一条chromosome呢? A:加一条 chromosome
Q:能具体说说第一个做法的坏处么?我感觉是不是更快些? A:就是怕 mismapping A:第一个会强迫所有跟这个序列有点相似的reads都比对上去 A:如果你肯定质粒上的序列没有和任何基因组序列有相似的话也可以,但是原则上不好 A:如果要量化 那就会导致overestimate A:随机错误,真实变异是有差别的,测序的技术可以区别的
Q:后续的.gff文件也要加入一条新注释,关于这个质粒或转基因的?比如,我想看它有多少的剪接方式,或者转录本到哪里就断了 A:這个用 STAR mapping 后就可以看到了吧
Q:nanopore的数据只需要用那个fasta_pass文件的数据就好了吧? A:对,但建议备份 fast5;以后软件升级了还可以重新 basecall
关于三代测序数据格式转换
Q:我下载了一个pacbio的数据,发现是fastq格式。我想转成pacbio的bam格式,大家有没有软件推荐。我用bwa转sam,然后samtools转bam。后面软件报错说不是valid pacbio bam A:pacbio我下的是这个格式:*hdf5.tgz A:pbbam; 或者大合集smrtlink,不过这个很难装
Q:pacbio bam文件包含的不仅仅是fastq文件的信息吧; 这个我装上了, 我不知道用哪个 A:pbbam应该是进行各种格式转换的。
Q:可以bam转pacbio的bam吗? A:你是fastq想转bam吗?
Q:我用baw和samtools把fastq转成了bam,发现这个bam格式pacbio不认。所以我想再重新做一下:1 fastq转pacbio的bam,或者2 把转出来的bam转成pacbio的bam;这两条路都行 A:这是反过来的操作,pacbio现在给的就是自己定义的bam。如果是fastq想转bam,bamtools就可以。pacbio 在github推荐用bamtools A:一般是hdf5转bam,然后bam转fastq;bioconda或者smrtlink下面有个bam2fastq A:pacbio的input file一般是BAM file;他是想fastq to bam
Q:是的,我在NCBI上只见到了fastq格式,就下下来了
Q:我下载的这个数据,不知道为什么里面是fastq
关于三代高通量测序读长问题讨论集锦
Q:请教一下,一个 pacbio cell 能拿到多少reads, 每条 reads 有多长?
A:http://m.biotech.org.cn/thread?id=136694;我去搜了一下,不知道过没过时,这里面有说:每个SMRT cell平均生成5.7Gb的数据和496,040条聚合酶序列。读长分布是PacBio测序特有的,平均聚合酶读长为11.5 kb。其中一项研究是这样的产出
A:这个还是一年前的数据,今年6月全面升级,基本都是加倍。近期测了一个cell,数据产出有25Gb了。我的是3kb靶向测序的文库,总体质量上会差很多,打个6折应该都不过分。如果是测基因组,数据量和质量,应该会更加漂亮。所以,测基因组还是蛮靠谱的,当然,可能价格上还是偏贵。
Q:好厉害,不过不知道国内测序公司有没有买这种新机器。现在的测序平均长度达到35kb以上了?
A:国内大的测序公司都有新机子。平均读长跟文库大小有关,通常文库长一些,读长也会长。
Q:应该 Hi-fi read 和普通read 产量不同吧?Hifi 相当于一个分子读了几次,普通的低质量read 产量有多少呢
A:没有普通和hifi区别,总体升级了,换了个叫法而已。机子和试剂都进行了升级,从第一台到最新,我们实验室都测过。。。总体价格不变,数据量和质量一直在提升
Q:怎么我看好像普通 reads 的话数据量多许多呢?
A:你看Gb还是reads数目?
Q:Gb
A:这个更看文库大小和文库类型。
Q:他网站上说的这个 CLR ,说最高有160Gb 不靠谱吧?
A:这个就是直接读出来的数据,50kb是把11kb测了好多遍,他写了是30个小时的movie。
Q:也就是说如果 library 长度是 50kb 那就是读一次吗?
A:你看它文库大小,很大
Q:就是说文库越长越好呗?假如不要求精确的话。
A:这个大概规律,因为是单分子PCR酶会一直扩增,直到信噪比很差
A:那这样的话,还是需要二代校正
A:二代校正不行的,只能覆盖基因区。重复区短序列比对不上,也就没办法校正
Q:那些区域也就暂时忽略了
A:看你想要啥了,只要基因区的话还是可以的
A:因为基因组装里面,读长是关键指标
A:pacbio你就看最后实际的subreads
Q:那现在pacbio实际上还是13kb左右?
A:pacbio直接读出来的reads可以很长,但是你建库的长度是多少决定了你最终的数据;你说的13kb是subreads
A:不重复读的话, N50 50k以上无压力
A:单分子重复读是一种线性扩增,很好的策略嘛
A:这个就是pacbio的原理;不然它怎么矫正碱基质量;pacbio直接读出来的reads的碱基质量就85%的准确度
A:如果是循环测,对组装意义不大
A:是的嘛,但我觉得对于靶向测序,这个非常棒,读得次数越多,意味着每一条read都是有效的。
A:你说的没错,测得越多,对于碱基质量的纠正是有好处的。10x就是以前BAC的升级版而已。
*编者注:由于本期内容涉及到很多技术细节,故隐去了讨论者的姓名单位信息。CGM感谢群里热心帮忙解答疑问的各位同仁,希望大家在CGM这个大家庭里畅所欲言,多多交流,共同进步。
参考文献
- Schmitt MW, Kennedy SR, Salk JJ, Fox EJ, Hiatt JB, Loeb LA. Detection of ultra-rare mutations by next-generation sequencing. Proceedings of the National Academy of Sciences. 2012;109(36):14508-14513. DOI: 10.1073/pnas.1208715109
评论(0)
登录后即可发表评论。
登录暂无评论,来发表第一条评论吧!