植物泛基因组入门(下):技术挑战与育种前景
本文为2019年的方法讨论,文中的技术成本、通量和研究现状不作为当前规格说明。
继上次介绍完泛基因的基本概念,构建泛基因组序列的不同策略和最近发表的一系列高质量文章后,本次推文主要来谈谈目前植物泛基因组研究中的一些局限性(如果还没有看过上期文章的小伙伴,欢迎点击下面链接进行回顾)。
无标准化分析流程
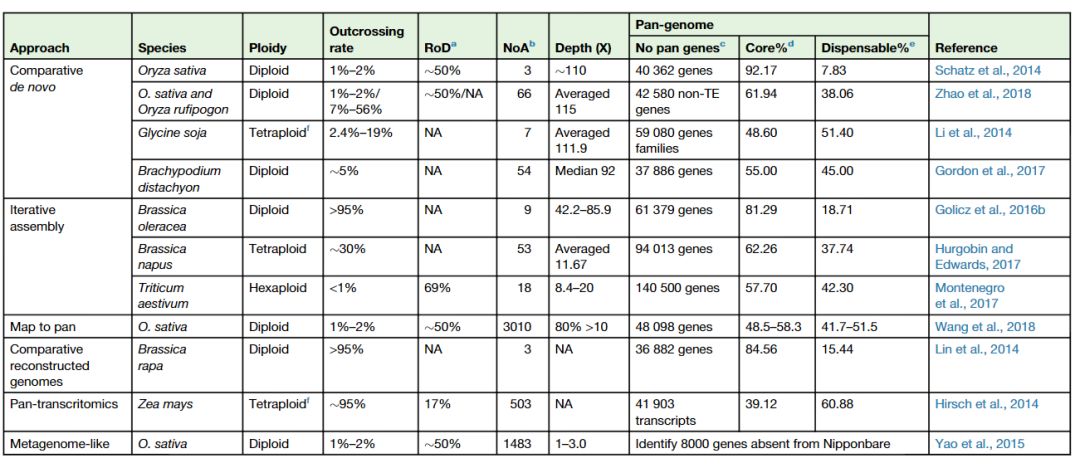
在Tao等人的有关植物泛基因组分析的综述论文中,作者从不同角度比较了目前植物泛基因组分析的特点(见下表)。从中可以看出,不同研究中使用到的样本数量(3至3000以上)、测序深度(1×至110×)、构建泛基因组的策略、序列注释方法以及判断基因有无变异(PAV)的方法都有很大的差别。这导致了即使对同一种物种来讲,不同实验室构建的泛基因组序列及基因有无变异结果不能进行直接的比较;在不同物种之间,也无法从系统进化的角度分析基因在植物进化及农作物驯化等生物过程中的基因流失或基因复制等现象。所以,植物的泛基因组分析亟需建立一套操作方便,结果精确,可移植性强的流程,包括样本量的选择,基因组的测序、组装,泛基因组的构建,序列注释等一系列生物信息学标准化分析流程。
技术的局限性
目前,大多数的植物泛基因组分析中使用的都是基于短读长的二代测序数据。但是,短读长序列的一个缺点是对重复序列区域的组装并不理想。而现有的植物泛基因组分析结果表明,非参考基因组序列很大一部分是由重复序列组成。所以,目前的泛基因组序列大都是一些长度较短的,高度碎片化的序列构成。一方面,这些重复序列的组装结果并不准确,另外一方面,组装出来的序列中的基因都是片段化的。非完整的基因序列为下游的基因有无变异分析带来偏差,无法得到正确的基因有无变异图谱。
相比之下,基于单分子实时的第三代测序技术能够产生较长的读长,能够跨过某些重复序列,在一定程度上解决泛基因组分析中的重复序列问题,从而产生更加精准的基因有无变异图谱。但是,目前来讲,三代测序技术测序错误率较高,通量较低,价格较贵,还无法应用于大规模的群体遗传学研究中。随着技术的不断发展,一些技术壁垒被突破,如目前的CCS长读长序列的测序准确度已经超过99.8%(Accurate circular consensus long-read sequencing improves variant detection and assembly of a human genome,2019,NBT),这为准确获取个体基因组的序列提供了技术的支持。相信随着三代测序技术的发展和普及,我们可以构建更加完整的植物泛基因组序列。
应用的局限性
泛基因组分析分析包括两个主要的内容,一是构建泛基因组序列,二是基于泛基因组的基因有无变异分析,建立泛基因组序列的基因浏览器,及后续的应用研究。目前,大多数的植物泛基因组研究的重点放在第一部分。
在第二部分中,目前大多泛基因组的应用就是构建一个泛基因的数据库。数据库里面主要是包含了新发现的基因的基本信息,还有这些基因与RNA-seq比对的信息,在不同群体中基因出现的频率等相关信息。泛基因组中,新发现(新组装出来参考序列没有)的基因可以进一步用于功能分析,下游的湿实验通路研究,基因选择育种等一些的应用中。目前在建立泛基因数据库这一块,做的最好的当数RPAN: Rice Pan-genome Browser。
但实际上建立数据库只是泛基因最基本的应用,对于实际的育种帮助还是处于很基础的阶段。为什么这样说呢?在上次番茄泛基因组发表之后,各路植物基因学术界的大牛都在推特上议论一 番。其中有大牛一针见血的提出了目前植物泛基因研究最大的局限。他说道:“他所认同的泛基因组,并不是单纯的将成百上千个个体进行测序比对,然后将所有比对不上参考基因组的 reads组装成一堆新的contigs,然后将其和参考基因组拼接成泛基因组。这些新的contigs既不能准确的放回到参考基因组中,进而进行基因定位克隆,更下游的分析,并且运用于育种中。也不能很准确的代表该物种所有个体的基因多样性。他理想中的泛基因组是类似一个图谱型的基因组,在每个变异位点上展示,所有个体的基因(各种突变)序列信息。”
推特上的讨论很准确的总结了,目前泛基因组在农业育种方法应用的最大阻碍。尽管如此,八月份在自然—生物技术发表的一篇文章“HISAT2和HISAT基因型的基于图谱型基因组比对和基因分型”为图谱型泛基因组的出现带来了曙光,随着数据的结构与分析流程的改进,未来泛基因组定会更好的运用于育种当中。
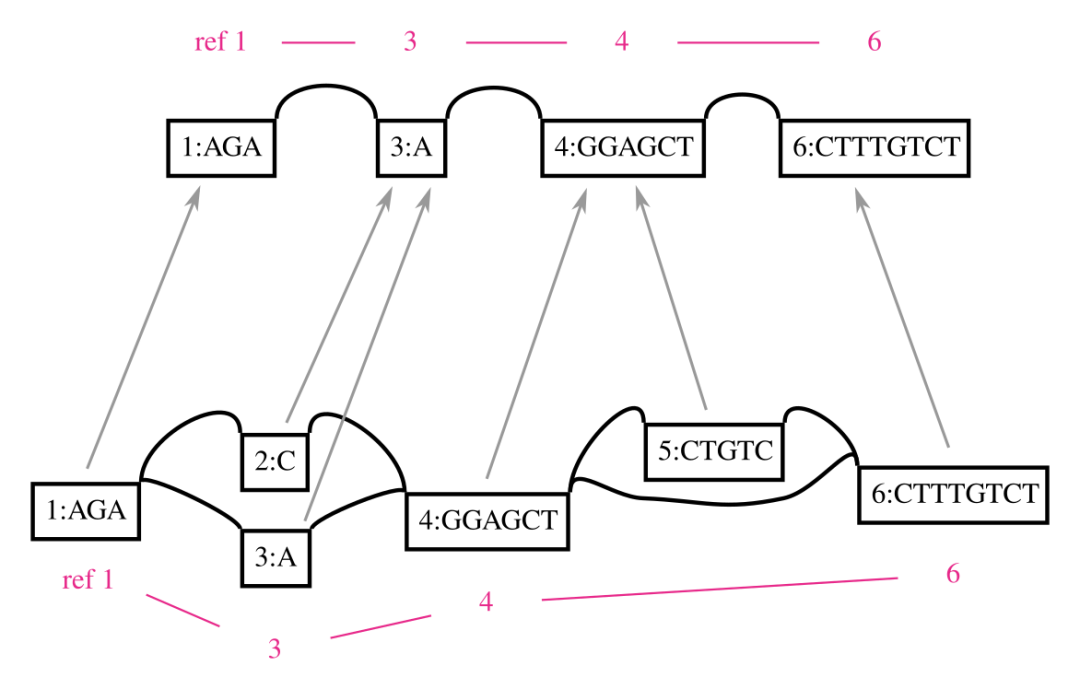
另外关于泛基因组未来的一些分析的思路,可以参考Li Heng博客中的想法,这里就不深入具体探讨了:http://lh3.github.io/2019/07/08/on-a-reference-pan-genome-modelhttp://lh3.github.io/2019/07/12/on-a-reference-pan-genome-model-part-ii
小结
由于当前技术或者其它因素的影响,当前泛基因组的研究在农业育种应用具有一定的局限性,也欠缺相对可比性。但随着三代技术的发展,和图谱型基因组的普及,植物泛基因组定会在未来迎来更快的发展,继续成为测序研究的热点话题。
参考文献
- Tao Y, Zhao X, Mace E, Henry R, Jordan D. Exploring and Exploiting Pan-genomics for Crop Improvement. Molecular Plant. 2019;12(2):156-169. DOI: 10.1016/j.molp.2018.12.016
- Kim D, Paggi JM, Park C, Bennett C, Salzberg SL. Graph-based genome alignment and genotyping with HISAT2 and HISAT-genotype. Nature Biotechnology. 2019;37(8):907-915. DOI: 10.1038/s41587-019-0201-4
- Wenger AM, Peluso P, Rowell WJ, Chang PC, Hall RJ, Concepcion GT, Ebler J, Fungtammasan A, Kolesnikov A, Olson ND, Töpfer A, Alonge M, Mahmoud M, Qian Y, Chin CS, Phillippy AM, Schatz MC, Myers G, DePristo MA, Ruan J, Marschall T, Sedlazeck FJ, Zook JM, Li H, Koren S, Carroll A, Rank DR, Hunkapiller MW. Accurate circular consensus long-read sequencing improves variant detection and assembly of a human genome. Nature Biotechnology. 2019;37(10):1155-1162. DOI: 10.1038/s41587-019-0217-9
评论(0)
登录后即可发表评论。
登录暂无评论,来发表第一条评论吧!