CGM 第10期:面向比较基因组学的无偏 k-mer 分析

不用单一参考基因组,怎样比较玉米中难以比对的重复序列?报告介绍 k-mer 计数与遗传定位相结合的思路,用于追踪拷贝数差异和演化变化。
活动回放
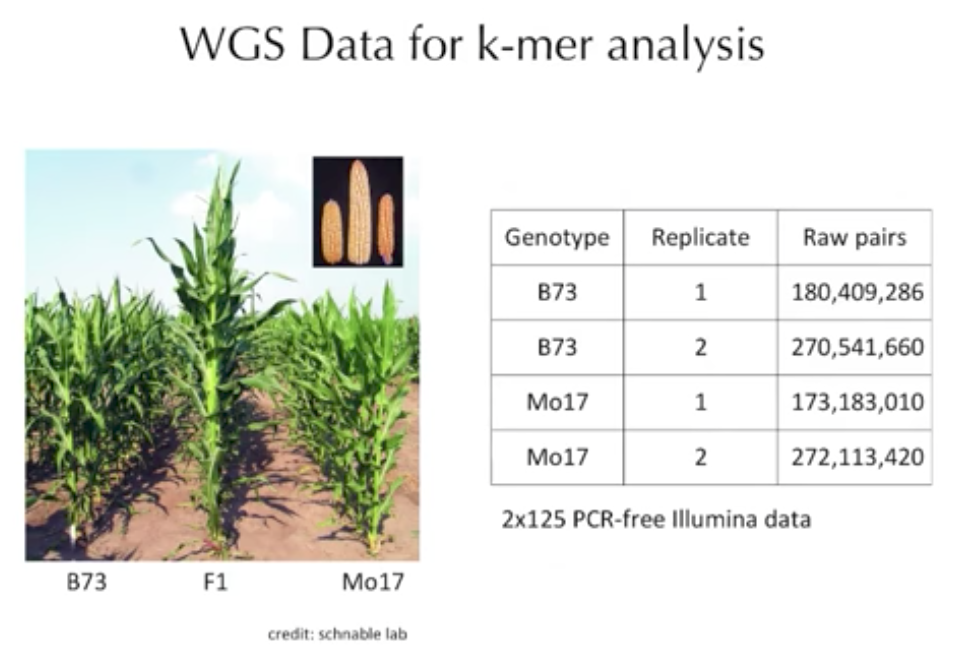
基因组的不同决定了大多数生物表型特征的差异。众多旨在寻找决定表型的基因类型(基因序列)的生物研究课题,让我们认识到,除了准确地定性或定量检测生物个体表型特征之外,我们还必须能够有效地分析不同个体之间基因组序列的差异。目前,比较基因组方法大多依赖于参考基因组。采用单一的参考基因组存在许多问题,例如,基因组序列代表性不够,在复杂多态性位点很难有效进行序列比对,无法有效地分析重复序列,等等。我们今天要讨论一种基于k-mer的比较基因组方法。k-mer分析不基于参考基因组,它是把大量的序列浓缩成许多独一无二的等长 DNA核酸序列(长度=k, 如25nt),并计算每条k-mer的出现次数。 我们采用k-mer方法分析原始测序数据来比较不同玉米基因组重复序列的拷贝数变化,并采用遗传的方法定位拷贝数差异的来源。同时,我们还发现了许多在玉米进化过程中显著变化的k-mers。
评论(0)
登录后即可发表评论。
登录暂无评论,来发表第一条评论吧!